全部文章 · 热点速递
Anthropic 发布 Claude Fable 5.2 和 Mythos 5.2,价格下调 20%
11 月 9 日,Anthropic 正式发布 Claude Fable 5.2 和 Claude Mythos 5.2,推出面向复杂技术任务、长时间运行的 AI Agent 和深度研究的新一代模型。
分享: WhatsApp · Telegram · X · Facebook · LinkedIn · Email

新模型强化了推理、编程和 Agent 能力,输出速度最高提升 30%,价格比上一代降低 20%。不过,Anthropic 仍建议大多数日常任务优先使用 Opus 5.5。
此次升级有两个最受关注的变化:标准 API 价格下调 20%,输出速度最高提升 30%。
Fable 5.2 已在 Anthropic 的多个平台上线。Mythos 5.2 则采用相同的底层模型,但仅向通过 Anthropic 网络安全和生命科学验证计划的机构开放。
Claude Fable 5.2 有哪些升级?
Anthropic 表示,新模型在编程、推理、视觉理解以及处理复杂开放式任务方面都有所提升。
主要技术规格如下:
| 参数 | Fable 5.2 |
|---|---|
| 上下文窗口 | 100 万 Token |
| 最大输出长度 | 128K Token |
| 输入价格 | $8 / 百万 Token |
| 输出价格 | $40 / 百万 Token |
| 输出速度 | 比 Fable 5.1 最快提升 30% |
| 思考机制 | 自适应思考 |
| Fast mode | Token 生成速度最高提升 2.5 倍 |
Fable 5.2 主要面向高难度推理和长时间运行的 Agent 任务,包括持续数小时的 AI 会话、多步骤深度研究,以及需要最终生成完整文档、电子表格或演示文稿的工作。
Anthropic 还重点展示了新模型在多个技术领域的进展。
编程与软件工程
Anthropic 表示,在正式发布前的测试中,Fable 5.2 帮助工程师完成了此前被认为难以实现的软件迁移项目。
数学研究
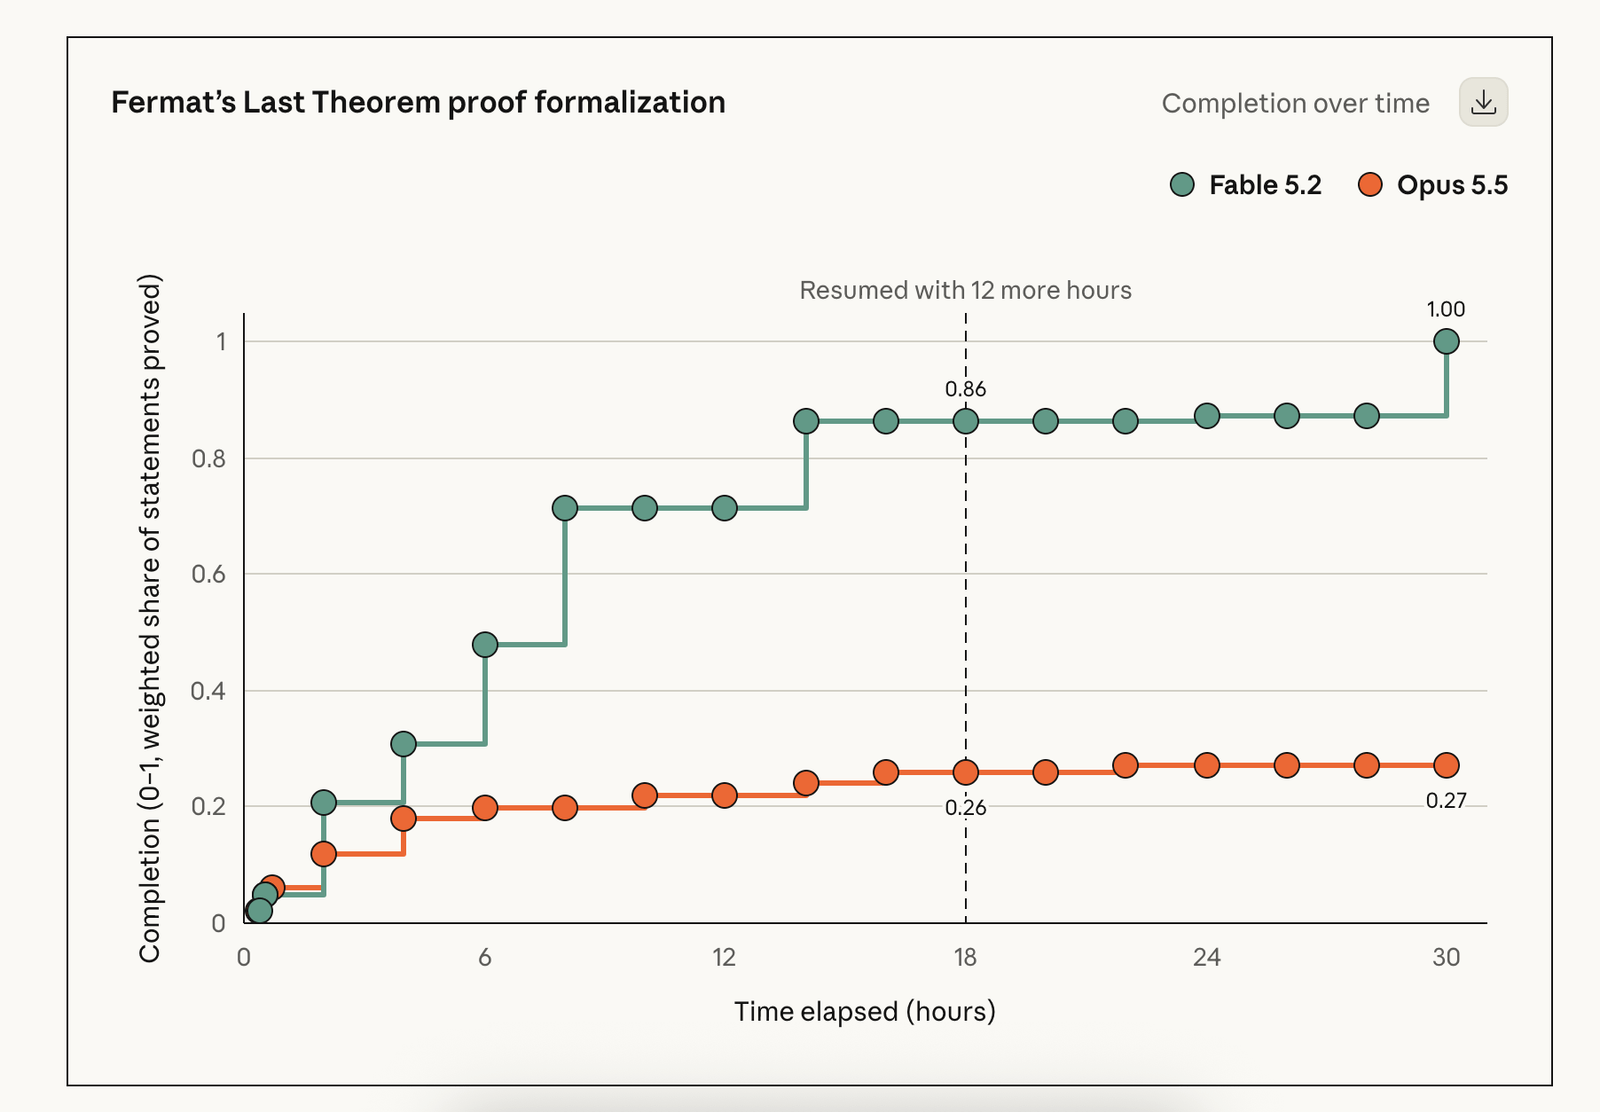
根据 Anthropic 的介绍,由 1,000 个 Fable 5.2 Agent 组成的团队,在 30 小时内完成了费马大定理证明的形式化工作。整个过程只需要极少的人类干预,也没有使用数学参考资料,而是依靠中间定理的陈述来衡量进度。
硬件与机器人
Anthropic 称,Fable 5.2 从零开始设计了三款可正常工作的电子设备,包括电路板、3D 打印外壳和软件。
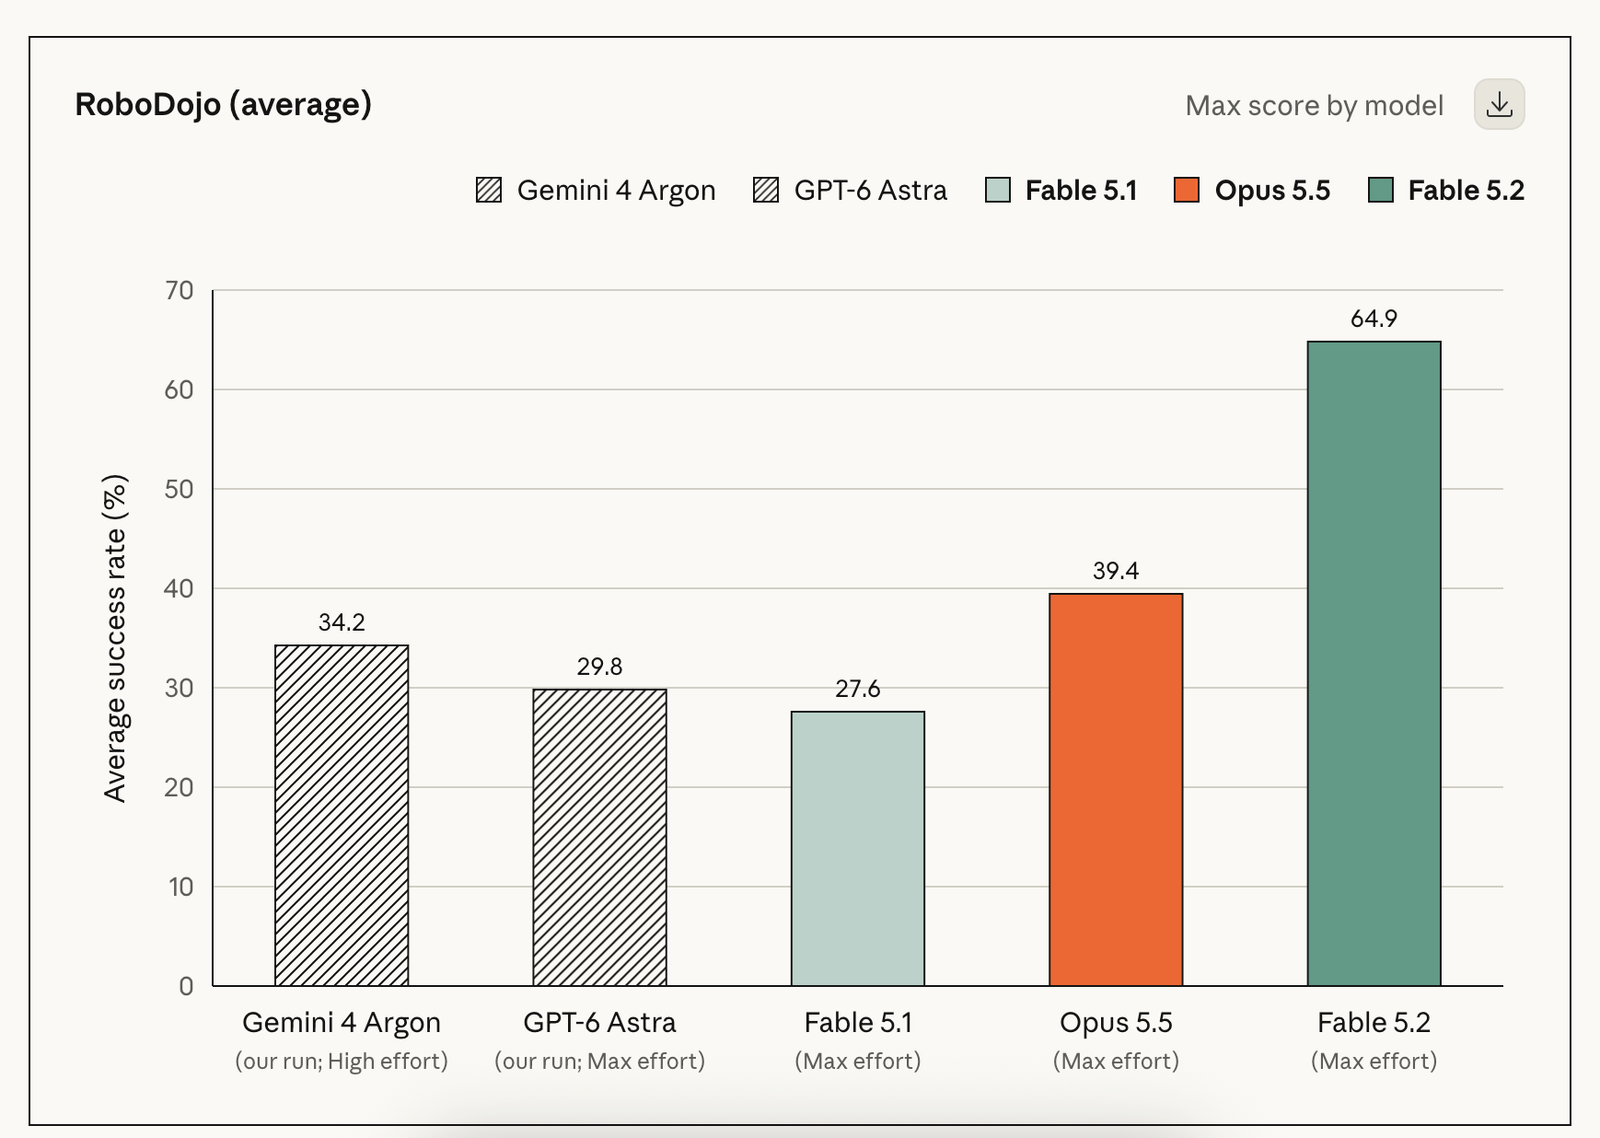
在 RoboDojo 模拟机器人基准测试中,Fable 5.2 在 Max effort 下取得 64.9% 的成绩。按照 Anthropic 的内部对比数据,这一成绩超过 GPT-6 Astra 和 Fable 5.1 的两倍。
这些案例反映出一个更大的方向:AI 正在从回答问题、生成代码片段,逐步走向跨多个阶段协调和执行复杂工作。
说明:上述应用案例和测试成绩来自 Anthropic 自行公布的数据,并不代表经过独立验证的性能保证。
新模型价格下调 20%
对于通过 API 使用 Claude 的开发者和企业来说,价格变化是此次发布中最直接的影响。
| 模型 | 输入 / 百万 Token | 输出 / 百万 Token |
|---|---|---|
| Fable 5.1 | $10 | $50 |
| Fable 5.2 | $8 | $40 |
| Opus 5.5 | $4 | $20 |
| Fable 5.2 Fast | $16 | $80 |
单位:美元 / 百万 Token。
与 Fable 5.1 相比,Fable 5.2 的输入和输出价格均下降 20%。
Anthropic 同时推出了 Fast mode,输出速度最高可提升至原来的 2.5 倍,但 Token 价格也会翻倍。
开发者还可以通过其他方式控制成本:
- Batch API: 符合条件的异步任务,输入和输出 Token 均可享受 50% 折扣。
- Prompt caching(提示词缓存): 重复使用已经处理过的提示词内容,可以降低相关成本。
- 模型选择: 日常简单任务使用成本较低的模型,不必全部交给高端模型处理。
来源:Claude Platform 2026 年 11 月 9 日更新记录
为什么 Anthropic 仍建议使用 Opus 5.5?
尽管价格有所下降,Anthropic 并没有将 Fable 5.2 定位为所有任务的默认模型。
该公司建议,大多数编程和知识工作应先使用 Opus 5.5,再根据任务的复杂程度选择更高或更低级别的模型。
原因很直接。
Fable 5.2 的输入和输出价格分别为每百万 Token $8 和 $40,而 Opus 5.5 分别为 $4 和 $20。
换句话说,Fable 的标准 Token 单价仍然是 Opus 的两倍。
但 Token 单价并不能完整反映一项工作的实际成本。
能力更强的模型可能通过减少重试、降低人工干预次数,或使用更少的总 Token 来完成复杂任务。因此,即使单个 Token 更贵,最终完成一项任务的总成本也可能更低。
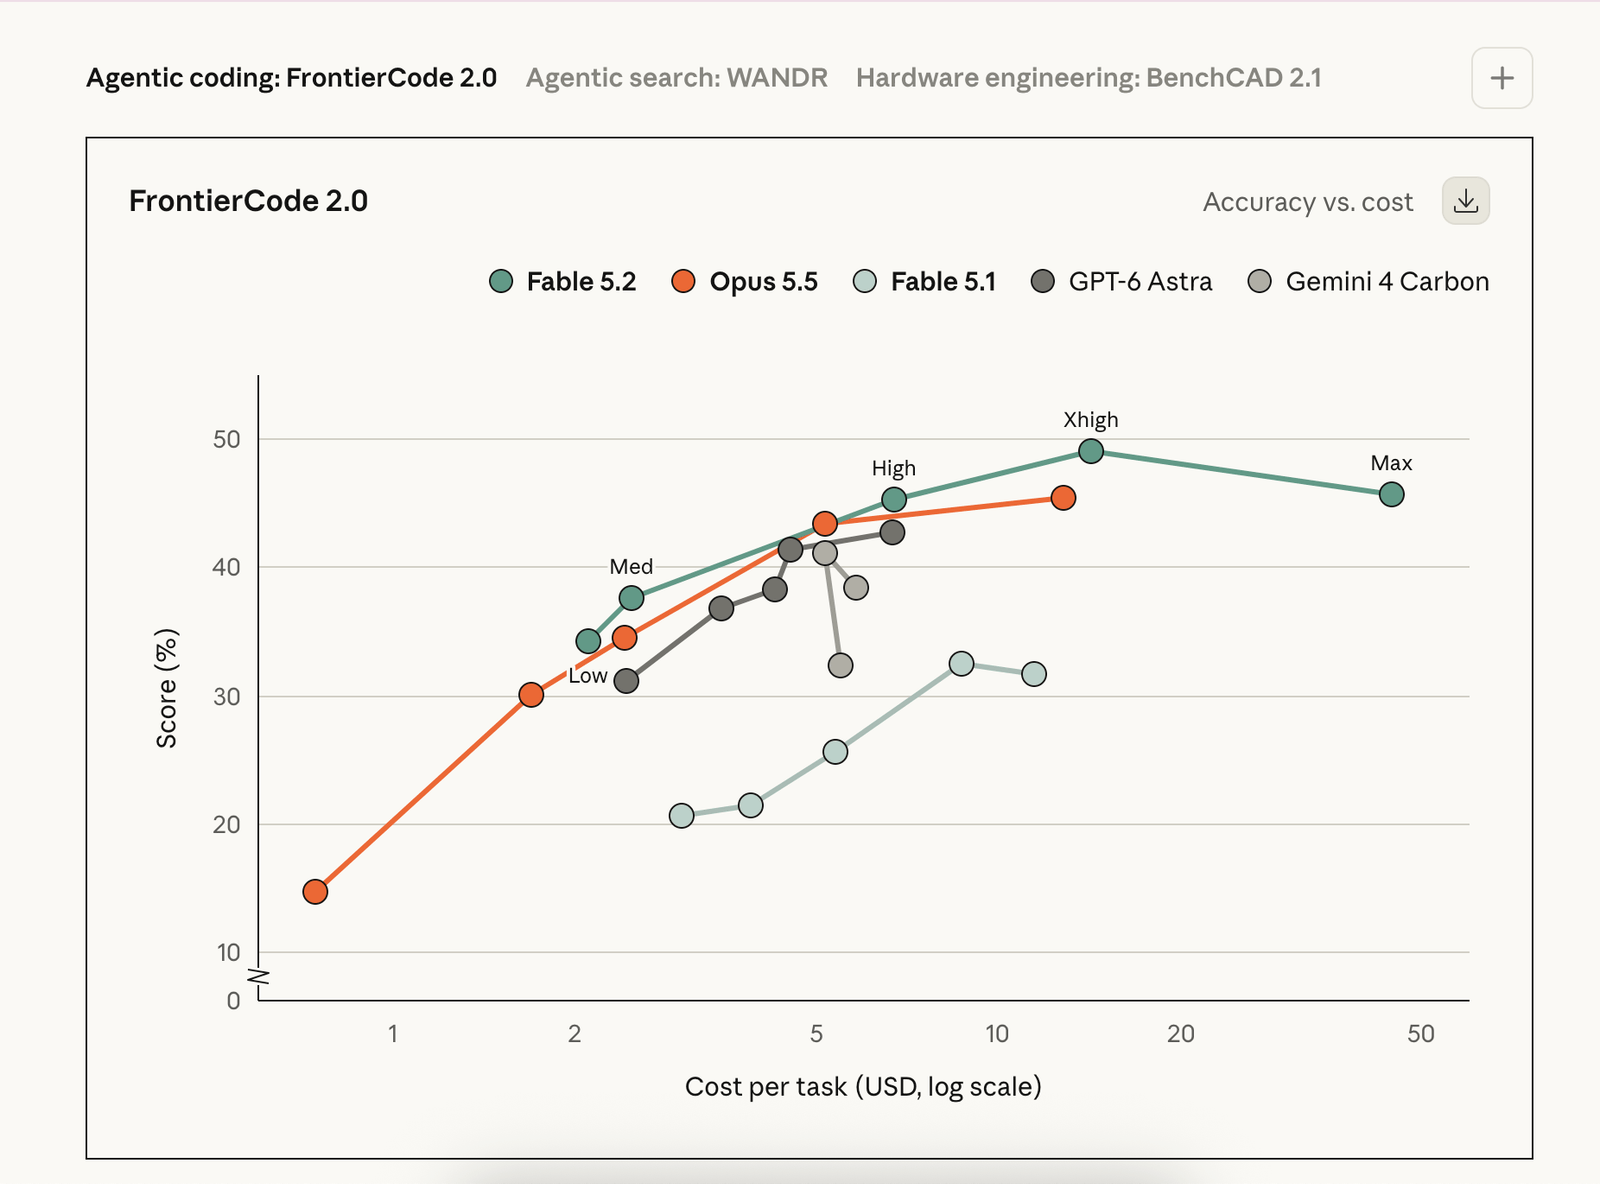
Anthropic 自己公布的 FrontierCode 2.0 测试体现了这一点:Fable 5.2 在 High effort 下得分为 45.3%,Opus 5.5 在 Max effort 下得分为 45.5%。Anthropic 表示,Fable 完成相关测试任务的成本约为 Opus 的一半。
因此,Fable 更适合需要深度推理和长时间自主执行的工作,而不是全面取代 Opus。
Anthropic 还建议将 Fable 用于两种角色:
- Advisor(顾问): 当较小的模型遇到难题时,向 Fable 寻求帮助。
- Orchestrator(协调者): 由 Fable 负责协调工作,并将简单任务分配给成本更低的模型。
来源:Anthropic - 模型使用建议与 FrontierCode 测试
这对 Shopify 商家意味着什么?
此次发布对直接承担 AI 模型调用费用的企业和代理机构影响最大。
对于使用 Claude Code 或 Claude API 开发和维护 Shopify 商店的代理机构来说,Token 价格下降有望降低开发、调试、研究和店铺维护成本。
但实际影响取决于使用方式。
直接按 API 用量付费的代理机构和开发者
他们可以直接受益于 Fable 的降价。不过,Fable 每个 Token 的价格仍高于 Opus 5.5,因此应该根据任务复杂程度和最终成本选择模型。
使用 AI 开发工具的 Shopify 团队
需要确认工具当前使用的底层模型,以及是否支持根据不同任务选择 Fable 5.2、Opus 5.5 或更小型模型。
按月订阅 AI 应用的商家
API 降价并不意味着订阅费用会自动下降。是否将成本节省传递给用户,取决于应用服务商的定价策略。
切换模型前应该检查什么?
- 确认当前 AI 开发流程实际使用的模型。
- 使用同一项真实的店铺开发任务测试 Fable 5.2 和 Opus 5.5。
- 比较总成本、完成时间、重试次数和人工修改次数。
- 只有当速度提升带来的价值足以抵消额外费用时,才使用 Fast mode。
更重要的变化是,AI 模型的选择正在成为企业运营成本管理的一部分,而不再只是选择最新或最强模型的问题。
Anthropic 此次发布让高级 AI 能力比上一代更便宜,但对 Shopify 企业来说,最合适的模型仍然取决于实际需要完成什么工作。
来源
官方一手资料
- Anthropic:Fable 5.2 和 Mythos 5.2 发布公告
- Claude Fable 5.2 技术文档
- Claude Mythos 5.2 技术文档
- Anthropic API 价格文档
- Claude Platform 更新记录
编辑说明: 性能、硬件设计、机器人测试和每项任务成本数据均来自 Anthropic 的官方测试结果。本文区分了公开的 API 定价与公司自行公布的 Benchmark 数据,不将后者表述为独立验证结果。
继续问 AI