Tất cả bài · Bài viết
Model rẻ chưa chắc làm chi phí Claude Code của bạn nhẹ hơn
Chuyển việc sang model rẻ hơn không phải lúc nào cũng làm chi phí Claude Code thấp hơn.
Chia sẻ: WhatsApp · Telegram · X · Facebook · LinkedIn · Email
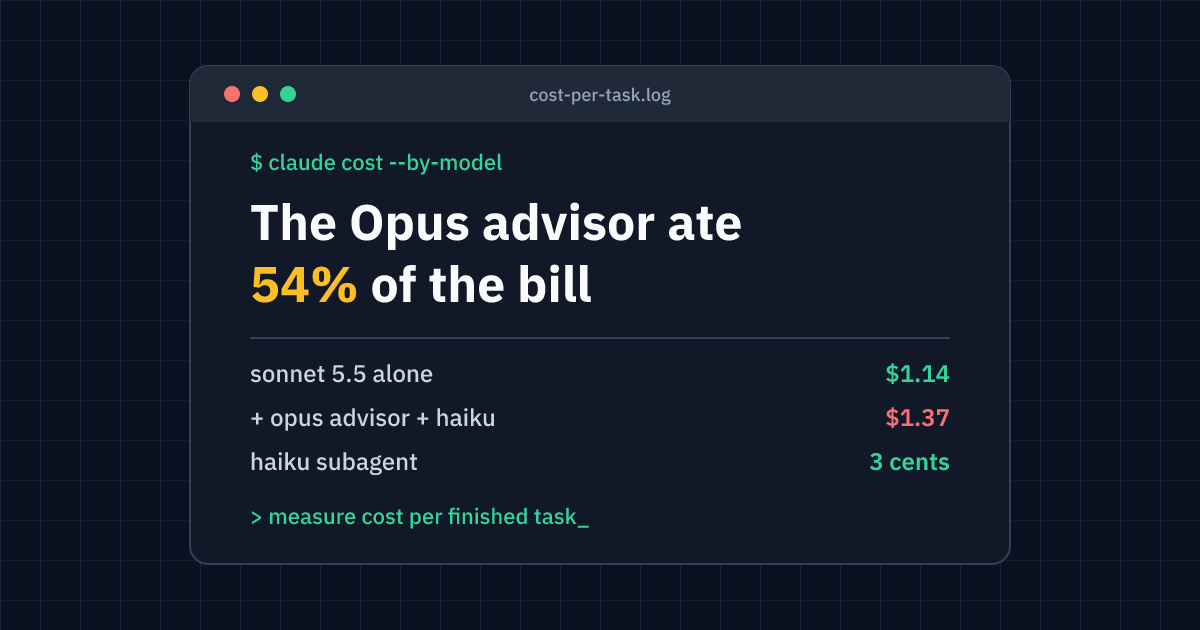
Trong tháng 10, một người dùng tự báo (không kèm dữ liệu) chi phí hằng tháng giảm từ 1.940 USD xuống 460 USD nhờ chia việc cho nhiều model và để một đoạn script chạy bộ kiểm thử thay cho model. Cũng trong tháng này, một lần thử khác cho thấy thêm một cố vấn Opus vào quy trình dùng model rẻ làm hóa đơn tăng cao hơn, trong khi phần Haiku chỉ tốn 3 cent.
Hai kết quả này thực chất không mâu thuẫn. Cả hai cho thấy chi phí nằm ở việc nào được chạy trên model đắt. Ngoài ra còn ba chỗ khiến chi phí lệch đi mà bảng giá token không cho thấy: ngữ cảnh bị đọc lại, mức effort (mức model được phép dành để cân nhắc cho mỗi việc) và những lần làm lại.
Nếu bạn dùng Claude Code để sửa theme hay dựng section, đó là những chỗ nên kiểm tra trước khi đổi model.
Cố vấn Opus đọc lại cả hội thoại mà không có cache
Một người dùng đã thử cách xếp ba model trên một lần sửa lỗi duy nhất: Sonnet 5.5 làm chính, Opus làm cố vấn, Haiku làm subagent (trợ lý chạy trong phiên riêng). Cả bộ hết 1,37 USD, trong khi chỉ dùng Sonnet 5.5 hết 1,14 USD. Cố vấn Opus chiếm 54% hóa đơn, còn Haiku chỉ tốn 3 cent. Theo người thử, mỗi lần gọi cố vấn đều đọc lại cả đoạn hội thoại mà không có cache (cơ chế giúp phần ngữ cảnh đã đọc được tính giá thấp hơn), nên riêng một lần gọi trên 100.000 token đã tốn 0,40 USD tiền input Opus. Người này cho rằng đòn bẩy thật là bao nhiêu việc rời khỏi Opus.
Skaly_Bull@Skaly__BullYour Claude Code bill is not a Haiku problem
It is an Opus problem
The viral three-model stack got tested on one bug fix
Sonnet main, Opus advisor, Haiku subagents: $1.37
Plain Sonnet 5.5 on its own: $1.14
The Opus advisor ate 54% of that bill, Haiku cost 3 cents
Every advisor call rereads the whole transcript with no cache
One call over 100K tokens is $0.40 of Opus input
The 75% everyone quotes is Haiku 5.5 vs…Oct 12, 2026 · Xem trên X
Subagent cũng có chỗ tương tự. Một người dùng cho biết cache của subagent hết hạn sau 5 phút không hoạt động. Nếu nó chờ chạy test hoặc build lâu hơn mức đó, bước kế tiếp phải xử lý lại toàn bộ ngữ cảnh, và phần xử lý lại này tính nhiều hơn vào giới hạn sử dụng. Giữ cache 1 giờ giúp tránh chuyện đó, nhưng người này dẫn tài liệu chính thức rằng theo giá API, ghi cache 1 giờ tốn gấp 2 lần giá input gốc, còn ghi cache 5 phút gấp 1,25 lần. Vì thế họ khuyên chỉ bật cache 1 giờ cho subagent hay phải chờ, không bật cho mọi subagent.
Cùng bài đó còn có một mốc đáng biết với model có ngữ cảnh 1 triệu token như Opus 5.5: Claude Code mặc định chỉ nén lại (compact) hội thoại ở khoảng 967.000 token, nên đến lúc ấy mỗi tin nhắn đều mang theo cả cuộc trò chuyện. Lệnh /autocompact 400k đưa mốc nén xuống sớm hơn.
Một bộ quy tắc ngắn giảm chi phí nhiều nhất ở effort cao nhất
Tác giả Occam, một bộ 30 dòng quy tắc cho agent lập trình (đọc đúng chỗ cần đọc, dùng lại code có sẵn, nói gọn), tự công bố kết quả thử trên 18 ca lập trình, chạy năm vòng với ba model. So với không dùng bộ quy tắc, Sonnet 5.5 ở effort cao nhất giảm 55% chi phí ước tính theo giá niêm yết do Claude Code báo, và qua 17 trên 18 ca kiểm tra so với 16 ca khi không dùng, chênh một ca. Ở effort medium, mức giảm của Sonnet chỉ 3% và khoảng tin cậy 95% còn bao gồm số 0, nghĩa là chưa chứng minh được khoản tiết kiệm. Với Opus 5.5, mức giảm là 51% ở effort cao nhất và 11% ở medium. Chính README của dự án ghi rằng kết quả chỉ đỡ được cho những ca này, chưa nói được cho mọi model hay mọi dự án.
Trong lần thử này, mức giảm lớn nhất xuất hiện ở effort cao nhất, còn ở medium thì nhỏ hơn nhiều.
Model mạnh hơn có thể rẻ hơn khi tính theo việc làm xong
Một bài phân tích về Sonnet 5.5 và Opus 5.5 cho rằng Sonnet rẻ hơn cho mỗi lần chạy, nhưng Opus vẫn có thể rẻ hơn cho mỗi việc làm xong, vì khác biệt nằm ở effort, những lần cache bị bỏ lỡ và những lần chạy lại đã trả tiền mà không ra kết quả.
rari@0xwhrrariSonnet 5.5 is cheaper per run
Opus 5.5 can still be cheaper per finished task
The difference is in effort, cache misses and the retries you paid for but never shipped
I broke down when to use each model and how to measure what the job actually costs ↓ https://t.co/sPjFexZrZlOct 3, 2026 · Xem trên X
Theo bảng giá tác giả ghi ngày 3/10, mỗi triệu token của Sonnet 5.5 tốn 2 USD input mới và 10 USD output, Opus 5.5 là 4 USD và 20 USD, còn giá đọc cache của cả hai đều là 0,20 USD. Sau đó, Anthropic thông báo giảm một nửa giá đọc cache của Sonnet 5.5, còn 0,10 USD, giúp Sonnet chạy rẻ hơn khoảng 20% trên phần lớn việc agentic. Thay đổi này chỉ áp dụng cho API, giới hạn sử dụng của Claude Code không đổi.
Do đó, chúng tôi thấy thước đo hợp lý hơn là lấy tổng tiền của mọi lần chạy, kể cả lần hỏng, chia cho số việc qua được bài kiểm tra bạn đặt ra. Bài phân tích trên gợi ý dùng chính bài kiểm tra sẽ chặn một lần merge làm chuẩn, và xem riêng nhóm việc khó.
Ví dụ trong bài là nếu mức rẻ nhất xử lý được 90% yêu cầu nhưng đốt nửa ngân sách vào 10% còn lại, con số trung bình có thể che mất phần đó.
Trước khi tối ưu, hãy kiểm tra model nào thật sự chạy
Nếu không đặt model cho subagent, nó dùng model của phiên chính, theo một bài hướng dẫn chuyển subagent sang model rẻ. Subagent Explore tích hợp sẵn cũng vậy. Bài đó nêu Opus 5.5, model chính mặc định, giá 4 và 20 USD mỗi triệu token, còn Haiku 5.5 là 0,10 và 0,50 USD cho yêu cầu dưới 100.000 token, tức chênh khoảng 40 lần về giá token. Với yêu cầu dài hơn, giá Haiku 5.5 gấp năm lần mức đó.
Cũng trong bài, tác giả dẫn một báo lỗi trên kho Claude Code: các bản 2.1.283 đến 2.1.290 bỏ qua dòng model: haiku trong cấu hình subagent, và người báo thấy 279 trong 301 lần chạy vẫn dùng Opus 5.5.
Hãy đo trên chính việc của bạn
Chọn một việc lặp lại, chẳng hạn sửa một section theme theo cùng một yêu cầu cho nhiều khách, rồi chạy vài lần và ghi lại tổng chi phí, kể cả những lần hỏng. Sau đó đổi từng biến một: model, mức effort, thời gian cache, rồi tính lại chi phí cho mỗi việc xong. README của Occam cũng khuyên dùng các lần thử lặp lại để đo việc của chính bạn.
Người báo chi phí giảm từ 1.940 USD xuống 460 USD cũng nói rõ đội agent tốn nhiều token hơn một phiên đơn, và khoản tiết kiệm đến từ việc phân đúng việc cho đúng model, cùng bước kiểm thử chạy bằng code. Bảng giá chỉ cho biết một token tốn bao nhiêu, còn một việc được hoàn thành tốn bao nhiêu thì chỉ khi đo trực tiếp trên việc của bạn mới trả lời được.