全部文章 · 文章
换便宜模型,Claude Code 账单未必会变轻
把任务交给更便宜的模型,Claude Code 的开销不一定就会下降。
分享: WhatsApp · Telegram · X · Facebook · LinkedIn · Email
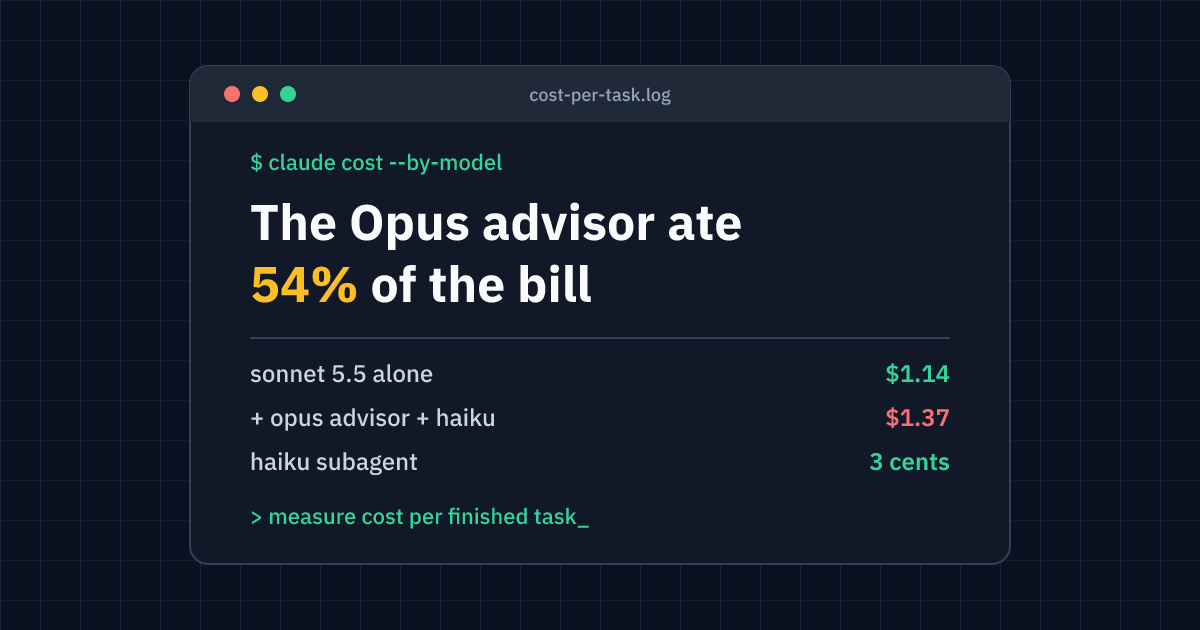
10月,有用户自称(未附数据)月度开销从1,940美元降到460美元,做法是把任务分给多个模型,并让一段脚本代替模型跑测试套件。同月另一次测试却显示,在用便宜模型的流程里加一个 Opus 顾问,账单反而更高,而 Haiku 那部分只花了3美分。
这两个结果其实并不矛盾。两者说明的都是:成本取决于哪些任务落在了贵模型上。此外还有三处会让开销偏离,而按 token 计价的价目表看不出来:被反复读取的上下文、effort 档位(模型在每个任务上可以花多少力气思考),以及返工重跑。
如果你用 Claude Code 改主题或搭 section,换模型之前,先查这几处。
Opus 顾问每次都在无缓存的情况下重读整段对话
有用户在一次修 bug 中试了三模型组合:Sonnet 5.5 做主力,Opus 当顾问,Haiku 当 subagent(在独立会话里运行的助手)。整套下来花了1.37美元,只用 Sonnet 5.5 则是1.14美元。Opus 顾问占了账单的54%,Haiku 只花了3美分。据测试者说,每次调用顾问都要在没有缓存的情况下重读整段对话(缓存能让已读过的上下文按更低价格计费),所以单次超过10万 token 的调用,光 Opus 输入就要0.40美元。这位用户认为,真正的杠杆是有多少工作能从 Opus 身上挪走。
Skaly_Bull@Skaly__BullYour Claude Code bill is not a Haiku problem
It is an Opus problem
The viral three-model stack got tested on one bug fix
Sonnet main, Opus advisor, Haiku subagents: $1.37
Plain Sonnet 5.5 on its own: $1.14
The Opus advisor ate 54% of that bill, Haiku cost 3 cents
Every advisor call rereads the whole transcript with no cache
One call over 100K tokens is $0.40 of Opus input
The 75% everyone quotes is Haiku 5.5 vs…Oct 12, 2026 · 在 X 上查看
Subagent 也有类似的坑。一位用户指出,subagent 闲置5分钟后缓存就会过期。如果它等测试或构建的时间超过这个长度,下一步就得把整个上下文重新处理一遍,而这部分重处理会更多地计入用量上限。保留1小时缓存可以避开这个问题,但这位用户引用官方文档称,按 API 价格,写入1小时缓存的费用是基础输入价格的2倍,写入5分钟缓存则是1.25倍。因此他们建议只给经常要等待的 subagent 开1小时缓存,而不是所有 subagent 都开。
同一篇帖子还提到一个值得留意的节点,适用于 Opus 5.5 这类100万 token 上下文的模型:Claude Code 默认要到约96.7万 token 才压缩(compact)对话,在那之前每条消息都会带上全部对话内容。用 /autocompact 400k 命令可以把压缩点提前。
一套简短规则,在最高 effort 下省得最多
Occam 是一套30行、面向编程 agent 的规则(只读该读的地方、复用已有代码、回答简短)。作者自行公布了测试结果:18个编程用例,三个模型,各跑五轮。与不用规则相比,Sonnet 5.5 在最高 effort 下,按 Claude Code 报出的标价估算,成本降了55%,检查通过18个中的17个,不用规则时是16个,差一个。在 medium effort 下,Sonnet 只降了3%,且95%置信区间仍包含0,也就是说节省并未得到证明。Opus 5.5 在最高 effort 下降了51%,medium 下降了11%。项目 README 自己也写明,结果只适用于这些用例,不能推广到所有模型或所有项目。
在这次测试里,降幅最大的出现在最高 effort,到了 medium 就小得多。
按完成的任务算,更强的模型可能更便宜
一篇对比 Sonnet 5.5 和 Opus 5.5 的分析认为,Sonnet 每次运行更便宜,但按每个完成的任务算,Opus 仍可能更省,因为差别来自 effort、缓存未命中,以及付了钱却没出结果的重跑。
rari@0xwhrrariSonnet 5.5 is cheaper per run
Opus 5.5 can still be cheaper per finished task
The difference is in effort, cache misses and the retries you paid for but never shipped
I broke down when to use each model and how to measure what the job actually costs ↓ https://t.co/sPjFexZrZlOct 3, 2026 · 在 X 上查看
按作者标注10月3日的价目表,每百万 token,Sonnet 5.5 的新输入是2美元、输出10美元,Opus 5.5 分别是4美元和20美元,两者的缓存读取价都是0.20美元。之后,Anthropic 宣布把 Sonnet 5.5 的缓存读取价减半至0.10美元,让 Sonnet 在大部分 agentic 任务上便宜约20%。这项调整只适用于 API,Claude Code 的用量上限不变。
所以我们认为更合理的指标是:把所有运行的总花费(包括失败的)除以通过你设定检查的任务数。 上面那篇分析建议,直接拿会拦下一次 merge 的那项测试当标准,并把难任务单独拿出来看。
文中举的例子是:如果最便宜的档位能处理90%的请求,却把一半预算烧在剩下10%上,平均数可能会把这部分掩盖掉。
优化之前,先确认实际跑的是哪个模型
根据一篇教人把 subagent 换成便宜模型的指南,如果不给 subagent 指定模型,它会沿用主会话的模型,内置的 Explore subagent 也一样。指南列出,默认主模型 Opus 5.5 每百万 token 为4美元和20美元,而 Haiku 5.5 在请求低于10万 token 时为0.10美元和0.50美元,token 单价相差约40倍。请求更长时,Haiku 5.5 的价格是这个水平的五倍。
作者在同一篇里还引用了 Claude Code 仓库中的一份 bug 报告:2.1.283 到 2.1.290 版本会忽略 subagent 配置里的 model: haiku 这一行,报告者发现301次运行中有279次仍在用 Opus 5.5。
拿你自己的任务来测
挑一个重复性的任务,比如按同一需求给多个客户改同一个主题 section,跑几次,记下总花费,失败的也算进去。然后一次只改一个变量:模型、effort 档位、缓存时长,再重新算每个完成任务的成本。Occam 的 README 也建议用重复测试来衡量你自己的工作。
报告从1,940美元降到460美元的那位用户也说得很清楚:agent 团队比单个会话更费 token,省下的钱来自把合适的任务交给合适的模型,再加上用代码跑的测试步骤。价目表只告诉你一个 token 多少钱,至于完成一个任务要花多少,只有在你自己的任务上实测才能回答。